
批量下载文档有救了:Python下载某网站文档保存PDF
迪丽瓦拉
2025-05-31 15:27:30
0次
人生苦短,我用python
最近毕业季要做毕业设计的同学真的特别多
需要大量文献、文档、PDF但是不想因为这个花money的
举起你们的双手!!!
接下来就以某度某库为例,
下载我们想要的文档并保存为PDF!
源码资料电子书:点击此处跳转文末名片获取
基本开发环境💨
Python 3.6
Pycharm
相关模块的使用💨
import requests
import parsel
import re
import os
import pdfkit
安装Python并添加到环境变量,
pip安装需要的相关模块即可。
需要使用到一个软件
wkhtmltopdf
这个软件的作用就是把html文件转成PDF
想要把文档内容保存成PDF,
首先保存成html文件,
然后把html文件转PDF
💥需求数据来源分析

网站分类有比较多种,
也可以选择自己要爬取的。
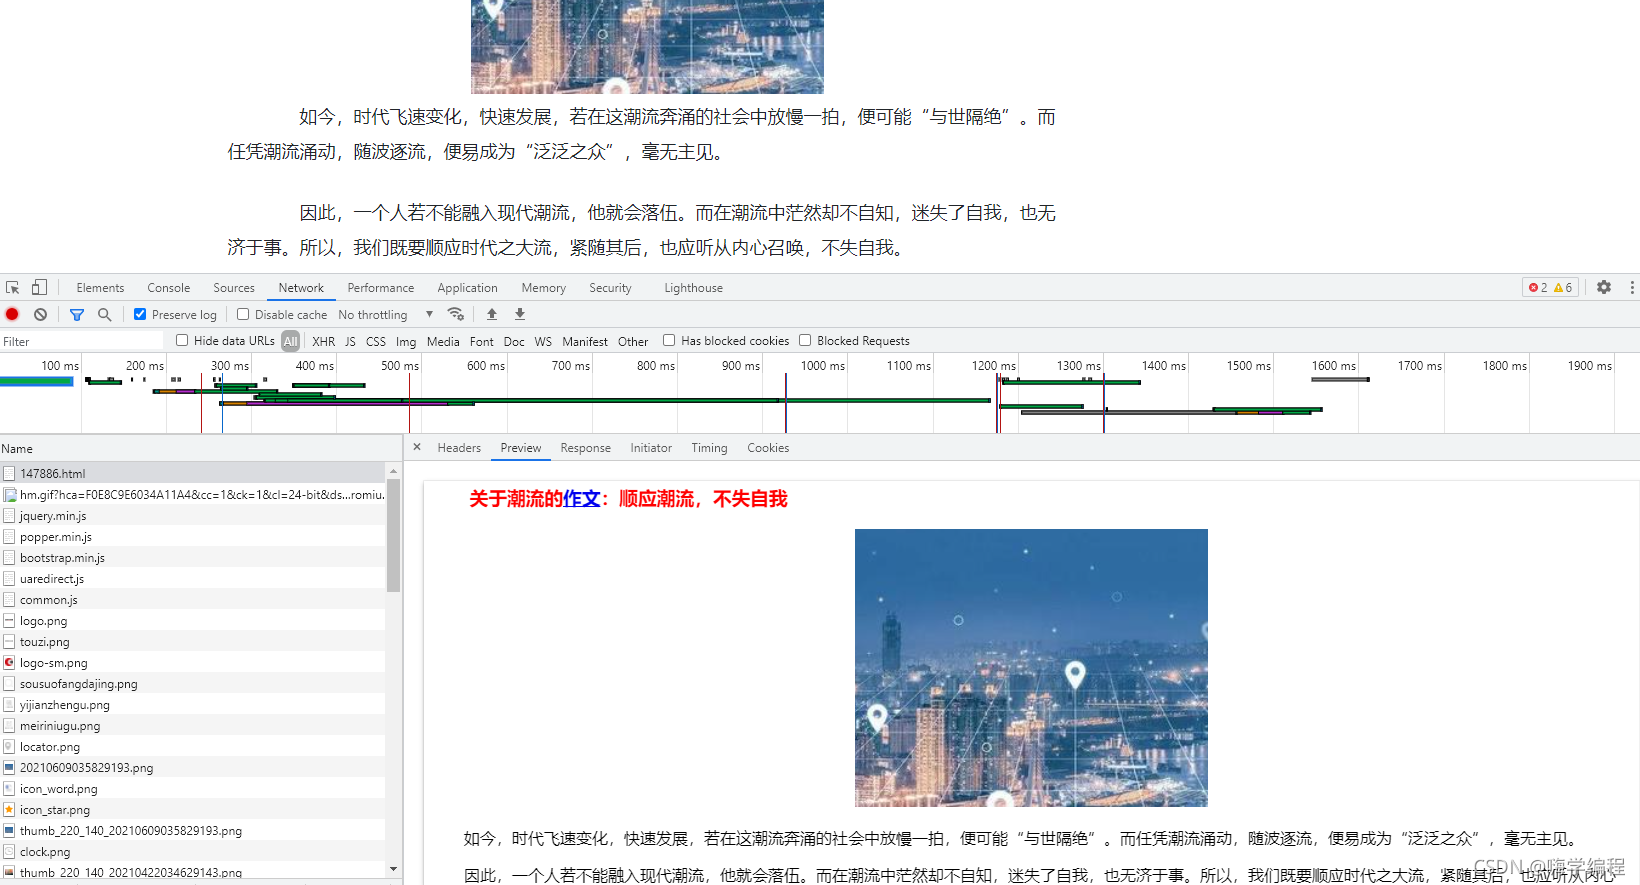
这个网站如果你只是正常直接去复制文章内容的话,
会直接弹出需要money的窗口…
但是这个网站上面的数据内容又非常好找,
因为网站本身仅仅只是静态网页数据,
可以直接获取相关的内容。
通过上述内容,
如果想要批量下载文章内容,
获取每篇文章的url地址即可,
想要获取每篇文章的url地址,
这就需要去文章的列表页面找寻相关的数据内容了。
💥整体思路
- 发送请求,对于文章列表url地址发送请求
- 获取数据,获取网页源代码数据内容
- 解析数据,提取文章url地址
- 发送请求,对于文章url地址发送请求
- 获取数据,获取网页源代码数据内容
- 解析数据,提取文章标题以及文章内容
- 保存数据,把获取的数据内容保存成PDF
- 转成PDF文件
💥代码实现
import requests
import parsel
import re
import os
import pdfkithtml_filename = 'html\\'
if not os.path.exists(html_filename):os.mkdir(html_filename)pdf_filename = 'pdf\\'
if not os.path.exists(pdf_filename):os.mkdir(pdf_filename)html_str = """


Document


{article}


"""def change_title(name):pattern = re.compile(r"[\/\\\:\*\?\"\<\>\|]")  # '/ \ : * ? " < > |'new_title = re.sub(pattern, "_", name)  # 替换为下划线return new_titlefor page in range(1, 11):print(f'正在爬取第{page}页数据内容')url = f'https:/自己替换一下/zlist-55-{page}.html'headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'}response = requests.get(url=url, headers=headers)href = re.findall('', response.text)for index in href:response_1 = requests.get(url=index, headers=headers)selector = parsel.Selector(response_1.text)title = selector.css('.content-page-header-div h1::text').get()title = change_title(title)content = selector.css('.content-page-main-content-div').get()article = html_str.format(article=content)html_path = html_filename + title + '.html'pdf_path = pdf_filename + title + '.pdf'try:with open(html_path, mode='w', encoding='utf-8') as f:f.write(article)# exe 文件存放的路径config = pdfkit.configuration(wkhtmltopdf='C:\\Program Files\\wkhtmltopdf\\bin\\wkhtmltopdf.exe')# 把 html 通过 pdfkit 变成 pdf 文件pdfkit.from_file(html_path, pdf_path, configuration=config)print(f'{title}保存成功...')except:pass
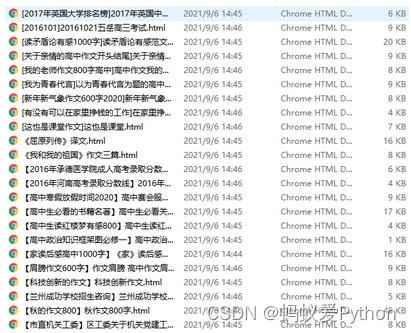
💥实现效果

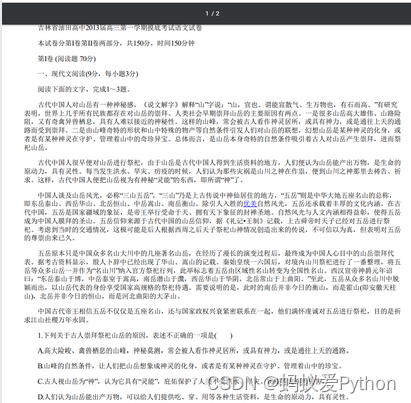
相关内容
热门资讯
AI做攻略、“双向奔赴”……国...
本文转自:人民网人民网记者 许维娜今年国庆假期,AI(人工智能)成了不少年轻人的“旅行搭子”。行前做...
合肥的这个“梗”, 翻篇了
社交平台的评论区,曾长期流传一句专属于合肥的黑色幽默。有人问合肥哪里好玩,本地网友半开玩笑地回复:合...
7万+旅游中高层都在的群,今天...
做旅游这行,资源卡位、渠道互通、项目落地——往往就差一个“对的机会”。我们的行业社群已聚集70,00...
一场帐篷音乐节,如何让井研从“...
帐篷音乐节现场封面新闻记者 周洪攀10月的研溪湿地,晚风里裹着柑橘的清甜与民谣的回响。夜幕降临,10...
白鹤翩翩落星愿,上海迪士尼度假...
10月9日,世界候鸟日前夕,上海迪士尼度假区星愿公园的湖风里多了一分白鹤的灵动。三座白鹤雕塑正式揭幕...
成都锦江边赏初秋枫叶飘飘
目前,成都锦江边国华街枫叶树红了。近年来,国华街附近的几条街都栽种了红枫树,是城区较集中看枫叶的点位...
GBTA:商务旅行正在复苏,但...
亚太正在成为全球商务旅行增长的重要引擎。在经历疫情后的快速反弹之后,全球商务旅行正在进入一个新的增长...
从景区焕新到节赛引流 邹城双节...
齐鲁网·闪电新闻10月9日讯 中秋、国庆“双节”假期,邹城市文化和旅游局提前谋划、周密部署,立足自身...
江山如此多娇 且看石楼今朝
金秋十月,黄河岸畔秋意盎然,丰收盛会喜迎国庆。本次石楼国庆文旅活动以“江山如此多娇,且看石楼今朝”为...
海南国庆假期接待游客475.4...
2026年国庆假期,海南接待游客475.40万人次,较2025年增长13.1%,较2024年增长15...