
【CNN】DenseNet——从特征角度考虑的神经网络
DenseNet论文名称:Densely Connected Convolutional Networks
DenseNet论文下载链接:
DenseNetpytorch代码实现:
前言
作为CVPR2017年的Best Paper, DenseNet脱离了通过加深网络层数(VGG,ResNet)和加宽网络结构(GoogLeNet)来提升网络性能的定式思维, 从特征的角度考虑, 通过特征重用和旁路(Bypass)设置,既大幅度减少了网络的参数量,又在一定程度上缓解了梯度弥散问题的产生。结合信息流和特征复用的假设, DenseNet当之无愧成为2017年计算机视觉顶会的年度最佳论文。
先列下DenseNet的几个优点,感受下它的强大:
1、减轻了vanishing-gradient(梯度消失)
2、加强了feature的传递,更有效地利用了不同层的feature
3、网络更易于训练,并具有一定的正则效果.
4、因为整个网络并不深,所以一定程度上较少了参数数量
一、Motivation
卷积神经网络在沉睡了近20年后, 如今成为了深度学习方向最主要的网络结构之一。从一开始的只有五层结构的LeNet,到后来拥有19层结构的VGG,再到首次跨越100层网络的Highway Networks与1000层的ResNet,网络层数的加深成为CNN发展的主要方向之一;另一个方向则是以GoogLeNet为代表的加深网络宽度。
随着CNN网络层数的不断增加,gradient vanishing和model degradation问题出现在了人们面前, BatchNormalization的广泛使用在一定程度上缓解了gradient vanishing的问题,而ResNet和Highway Networks通过构造旁路,进一步减少了gradient vanishing和model degradation的产生, Fractal Nets通过将不同深度的网络并行化, 在获得了深度的同时保证了梯度的传播,Stochastic Deep Network通过对网络中一些层进行失活,既证明了ResNet深度的冗余性,又缓解了上述问题的产生(失活操作对网络的影响与DenseNet还挺相似)。虽然这些不同的网络框架通过不同的实现加深的网络层数,但是他们都包含了相同的核心思想, 即:将不同层的feature map进行跨网络层的连接。
何恺明在提出ResNet时做出了这样的假设: 若某一较深的网络多出另一较浅网络的若干层,且这些层有能力学习到恒等映射, 那么这一较深网络训练得到的模型性能一定不会弱于该浅层网络。 通俗地说就是如果对某一网络中增添一些可以学到恒等映射的层组成新的网路, 那么最差的结果也是新网络中的这些层在训练后成为恒等映射而不会影响原网络的性能。同样DenseNet在提出时也做过假设: 与其多次学习冗余的特征,特征复用是一种更好的特征提取方式。
二、Model Architecture
假设输入为一个图片X 0, 经过一个L层的神经网络, 第 l 层的特征输出记作 X l.
那么残差连接的公式如下所示:
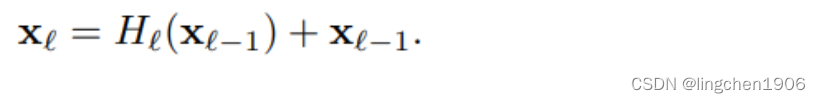
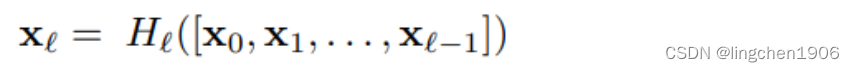
其中[ ]代表concatenation(拼接),既将第0层 到 l-1 层的所有输出feature map在channel维度上组合在一起。这里所用到的非线性变换H为BN+ReLU+ Conv(3×3)的组合。所以从这两个公式就能看出DenseNet和ResNet在本质上的区别,下面放一张DenseBlock的图片帮助理解公式:
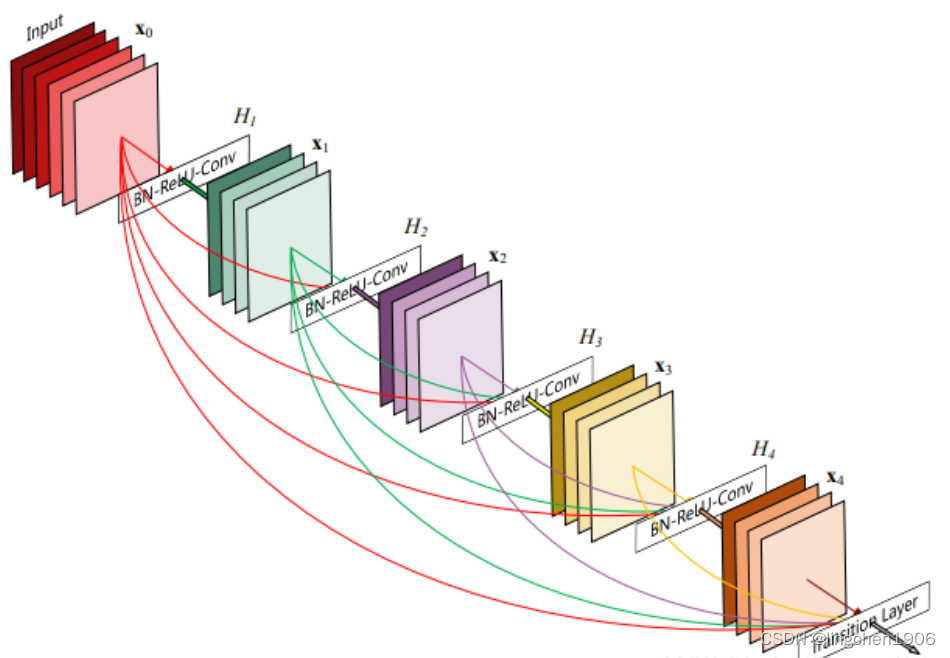
虽然这些残差模块中的连线很多看起来很夸张,但是它们代表的操作只是一个空间上的拼接,所以Densenet相比传统的卷积神经网络可训练参数量更少,只是为了在网络深层实现拼接操作,必须把之前的计算结果保存下来,这就比较占内存了。这是DenseNet的一大缺点。
Down-sampling Layer
由于在DenseNet中需要对不同层的feature map进行cat操作,所以需要不同层的feature map保持相同的feature size,这就限制了网络中Down sampling的实现.为了使用Down sampling,作者将DenseNet分为多个stage,每个stage包含多个Dense blocks, 如下图所示:
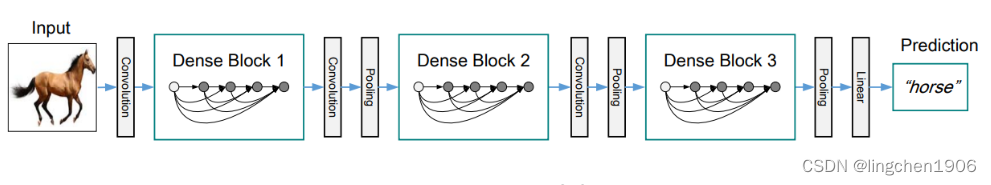
在同一个Denseblock中要求feature size保持相同大小,在不同Denseblock之间设置transition layers实现Down sampling, 在作者的实验中transition layer由BN + Conv(kernel size 1×1) + average-pooling(kernel size 2 x 2)组成。
注意这里1X1是为了对channel数量进行降维;而池化才是为了降低特征图的尺寸。
详细解释一下1X1卷积:因为每个Dense Block结束后的输出channel个数很多,需要用11的卷积核来降维。以上图的DenseNet-169的Dense Block(3)为例,其中包含32个 33的卷积操作,也就是第32个子结构的输入是前面31层的所有输出结果,假设每层输出的channel是32 ,第32层的33卷积操作的输入就是3132 +(上一个Dense Block的输出channel),近1000了。因此,这个transition layer有个参数reduction(范围是0到1),表示将这些输出缩小到原来的多少倍,默认是0.5,这样传给下一个Dense Block的时候channel数量就会减少一半,这就是transition layer的作用。文中还用到在最后的NN中使用dropout操作来随机减少分支,避免过拟合,毕竟这篇文章的连接确实多。
Growth rate
在Denseblock中,假设每一个卷积操作的输出为K个feature map, 那么第i层网络的输入便为(i-1)×K +(上一个Dense Block的输出channel), 这个K在论文中的名字叫做Growth rate, 默认是等于32的,这里我们可以看到DenseNet和现有网络的一个主要的不同点:DenseNet可以接受较少的特征图数量(32)作为网络层的输出。具体从网络参数如下图所示:
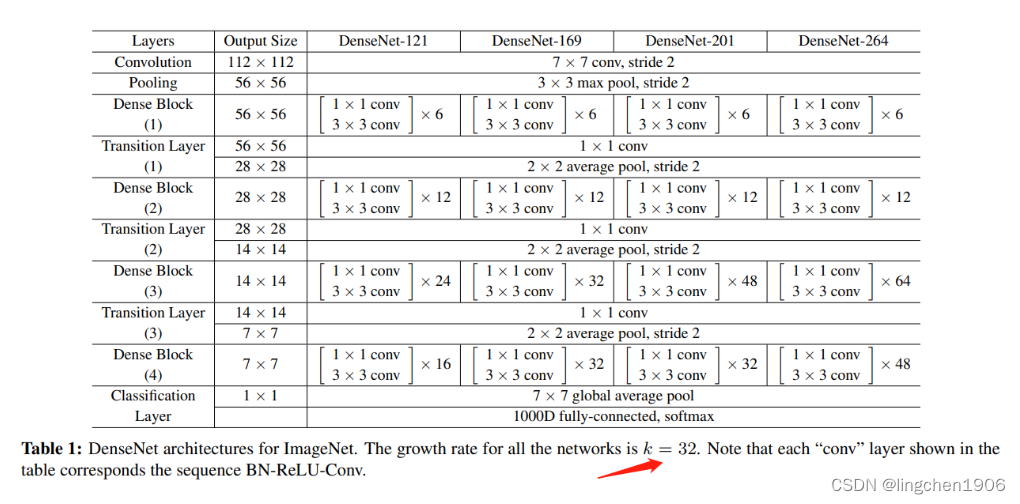
值得注意的是这里每个dense block的3X3卷积前面都包含了一个1X1的卷积操作,就是所谓的bottleneck layer,目的是减少输入的feature map数量,既能对通道数量降维来减少计算量,又能融合各个通道的特征。
三、Model Comparation
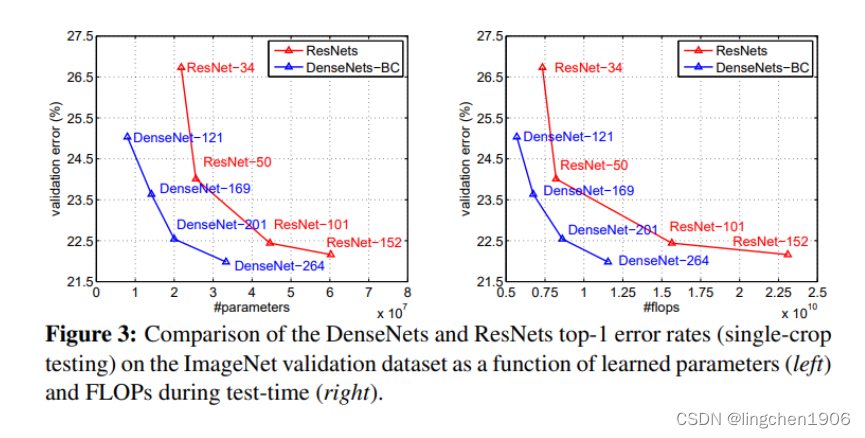
上图是DenseNet与ResNet的对比图,在相同的错误率下,DenseNet的参数更少,计算复杂度也越低。
但是,DenseNet在实际训练中是非常占用内存的!原因是在计算的过程中需要保留浅层的feature map为了与后面的feature map就行拼接。简单说,虽然DenseNet参数量少,但是训练过程中的中间产物(feature map)多;这可能也是为什么DenseNet没有ResNet流行的原因吧。
参考:
点头教育
下一篇:Linux文件与目录管理